Aller au contenu
Stage de 4 à 6 mois — à partir d'avril 2027

MLOps & Machine Learning EngineeringJ'affine des modèles, je les mets en production, et je sais prouver qu'ils marchent.

Élève ingénieur Big Data & IA à l'ECE Paris. Ce qui m'intéresse est la chaîne complète : affiner un modèle, le servir derrière une API, le conteneuriser et le déployer de façon reproductible. Deux stages en développement, dont un en Go sur un système déjà en production.

Pièce maîtresse

Ce qui se passe quand vous posez une question à RAG-Local

Un assistant documentaire dont aucune donnée ne quitte la machine. Voici le chemin réel d'une question à travers le système — les chiffres sont ceux du code.

Question+ historiqueRéécritureautonomeVectorielChroma · 20BM25lexical · 20Fusion RRFk = 60RerankingCPU → top 6Réponse citéeqwen3:8b · SSE100 % local — aucune requête réseau sortante
Étape 1 — Réécriture« Et pour les mineurs ? » ne veut rien dire seule. La question est reformulée en question autonome à partir de l'historique, sinon la recherche ne retrouve rien.
Étape 2 — Deux recherchesVectorielle pour le sens, BM25 pour les mots exacts. Vingt candidats chacune. Le vectoriel rate les références et les numéros ; BM25 les attrape.
Étape 3 — Fusion RRFLes deux classements fusionnent par Reciprocal Rank Fusion. Aucun poids à deviner : c'est le rang qui compte, pas le score.
Étape 4 — RerankingUn cross-encoder relit les candidats et n'en garde que six. Il tourne sur le CPU : le GPU reste entièrement dédié au modèle de chat.
Étape 5 — Réponseqwen3:8b répond en streaming avec des citations cliquables. Un clic ouvre la page exacte du PDF source. S'il ne sait pas, il le dit.

En chiffres

Ce qui existe vraiment

23Dépôts actifs
2Stages en entreprise
8Projets en vitrine
100 %Exécution locale

Projets

Huit projets, huit preuves

Chacun répond à une question qu'un recruteur se pose. Le chiffre est ce que j'ai pu établir ; la méthode se déplie en un clic, et le reste est dans le dépôt.

01 / 080requête réseau sortante : tout reste sur la machine

RAG-Local · assistant documentaire

Peut-il livrer un système d'IA sans exposer les données ?

Aucune donnée ne quitte la machine

Un assistant utile sur ses documents, sans envoyer un seul fichier à un service externe.

Recherche hybride (BM25 + vecteurs, fusion RRF), reranking cross-encoder, réponses citées à la page près. Les images des PDF sont décrites par un modèle de vision local et deviennent cherchables comme du texte. Une suite RAGAS mesure la qualité.

  • Mettre en production
  • Évaluer un RAG

FastAPI · Chroma · Ollama · Next.js · Docker Compose · RAGAS
02 / 08878 000lignes de vente analysées en SQL

Ventes en supermarché · analyse SQL

Sait-il faire parler une grande base avec du SQL ?

Trouver la valeur dans 878 000 lignes de vente

Savoir ce qui rapporte et ce qui coûte dans les ventes d'un supermarché : plus de 878 000 lignes de vente, prix de gros et taux de perte.

Des requêtes SQL analytiques (CTE, fonctions de fenêtrage) sur une base SQLite : produits les plus rentables, produits très vendus mais peu rentables, coût des pertes par catégorie, retours et effet des remises.

  • SQL avancé
  • Analyse métier

SQL · CTE · Fonctions de fenêtrage

03 / 08360paires retenues après audit, sur 500 générées

Mina-Translator · traduction français ↔ mina

Sait-il travailler quand la donnée n'existe pas ?

Une langue sans corpus

Le mina n'a aucun corpus parallèle public : sur une langue peu dotée, la difficulté est la donnée, pas l'entraînement.

Un corpus généré pour l'occasion puis audité par script : 360 paires exploitables sur 500, réparties en sept domaines, complétées par ~19 600 transcriptions Common Voice. Qwen2-0.5B affiné en QLoRA 4 bits, Whisper en amont, service FastAPI, et une application de collecte participative pour étendre le corpus.

  • Affiner un modèle
  • Construire la donnée

QLoRA · Whisper · FastAPI · Streamlit

04 / 087 Mdde paramètres : peu fiable seul, vérifié par les tests

SELF_DEV_AGENT · agent de développement

Peut-il rendre fiable un modèle qui ne l'est pas ?

Un agent qui vérifie son propre travail

Un modèle local de 7 milliards de paramètres n'est pas fiable : on ne peut pas croire ses réponses.

L'agent n'écrit pas du code en espérant : il explore, modifie, exécute les tests et se corrige. Il tourne entièrement en local via Ollama, avec un installateur en un clic qui choisit les modèles selon la RAM disponible.

  • Fiabiliser un modèle
  • Outillage

Ollama · Tool calling · AST · Python

05 / 08401 / 403sans jeton, ou pas l'auteur : refus testés en CI

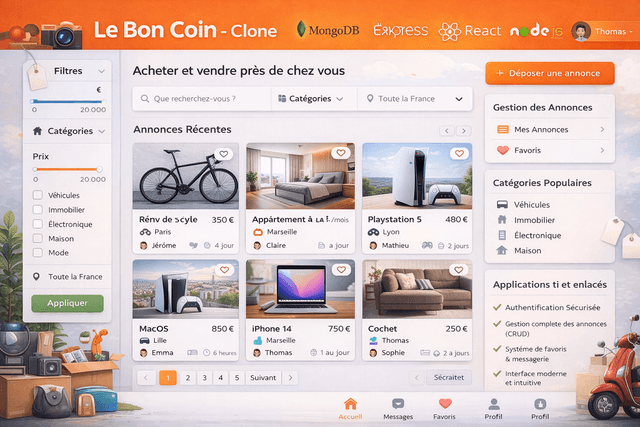
Le Bon Coin · plateforme d'annonces

Sait-il sécuriser un backend ?

Chaque annonce protégée de son auteur

Authentifier sans stocker de mot de passe en clair, et garantir qu'un utilisateur ne modifie que ses propres annonces.

Un backend Express découpé en contrôleurs, modèles, routes et middleware : mots de passe hachés avec bcrypt, jeton JWT vérifié par un middleware, contrôle de propriété sur chaque modification. Ces refus sont couverts par des tests, lancés par GitHub Actions avant chaque publication.

  • Concevoir un backend
  • Sécuriser une API

Node.js · Express · JWT · bcrypt · MongoDB · React

Résultat du projet Le Bon Coin
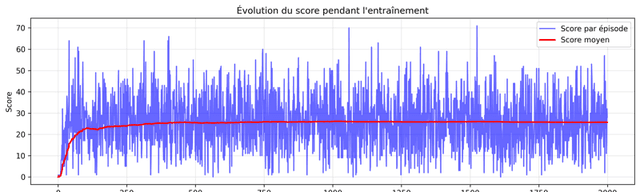
06 / 080règle écrite à la main : l'agent apprend seul

Snake RL · apprentissage par renforcement

Comprend-il ce qu'il entraîne ?

Un environnement écrit à la main

Apprendre à jouer à Snake sans aucune règle écrite à la main.

Environnement compatible Gymnasium écrit sur mesure, DQN en PyTorch avec réseau cible et mémoire de rejeu, entraînement sur GPU. Un projet en modules (agent, entraînement, évaluation, démonstration), pas un notebook.

  • Entraîner un modèle

PyTorch · Gymnasium · DQN

Résultat du projet Snake RL
07 / 081 : 1un magasin contrôle apparié à chaque magasin test

Optimisation des ventes · impact d'un agencement en magasin

Peut-il prouver un effet quand on ne peut pas tirer au sort ?

Mesurer sans pouvoir randomiser

Mesurer l'effet d'un nouvel agencement quand on ne peut pas tirer les magasins au sort.

Chaque magasin test est apparié à un magasin contrôle, choisi par corrélation sur les ventes et la fréquentation avant l'intervention, puis l'écart est testé statistiquement. C'est ce qui rend la mesure défendable. Restitution pour un Category Manager.

  • Prouver un effet
  • Inférence causale

pandas · Inférence causale · Tests statistiques

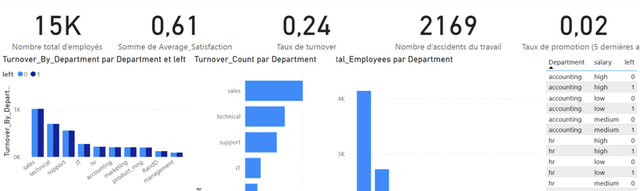
08 / 080,94d'AUC sur le jeu de test, sans le taux de satisfaction

Départ des employés · rétention des salariés

Sait-il mener une analyse RH jusqu'à un outil utilisable ?

Un modèle sans fuite, livré jusqu'au bout

Identifier les salariés à risque de départ, et ce qui les retient avant qu'ils démissionnent.

14 999 employés, 20 % de doublons retirés, puis trois modèles comparés. Le taux de satisfaction est écarté du modèle final pour éviter une fuite : la forêt aléatoire retrouve 90 % des départs réels sans lui. Le tout est livré jusqu'au bout : tableau de bord Power BI, API FastAPI déployée sur Railway et application Streamlit pour tester un profil.

  • Interpréter un modèle
  • Éviter la fuite de données
  • Livrer de bout en bout

Random Forest · Scikit-learn · FastAPI · Streamlit · Power BI

Résultat du projet Départ des employés

Démonstrations

Voir les projets à l'œuvre

Quatre scénarios joués au clic. Rien n'est exécuté pour de vrai — ce sont des simulations, et elles le disent.

Où sont mes photos prises à la plage ?

RAG-Local indexe un dossier de l'ordinateur et retrouve des images par leur contenu — elles ne contiennent pourtant aucun texte.

Visite guidée · RAG-LocalSimulation — aucun modèle n'est exécuté
~/Documents0 / 1 247
MDnotes_reunion.md—
PDFcontrat_prestation.pdf—
JPGIMG_2831.jpg—
XLSbudget_2026.xlsx—
PNGDSC_0147.png—
DOCrapport_annuel.docx—
WEBPcapture_ecran_plage.webp—
PDFarchives/2019.pdf—

Description écrite localement · IMG_2831.jpg

Espace de recherchenomic-embed-text
documentstableursautres photosphotos de plage0,910,870,79
Yendi Yohann
À propos

De l'affinage du modèle à son déploiement.

Un modèle qui reste dans un notebook ne sert à personne. Ce qui m'intéresse, c'est la partie que la plupart des gens sautent : rendre un résultat reproductible et savoir le mesurer — puis le servir derrière une API qui tient la charge.

Je viens du développement backend, et c'est ce qui fait la différence : je ne découvre pas Docker, les tests et l'intégration continue au moment de déployer. Je cherche un stage de 4 à 6 mois à partir d'avril 2027, en MLOps ou en data engineering.

Compétences

Technologies maîtrisées

Langages

PythonSQLGoTypeScriptJava

ML & modèles

PyTorchScikit-learnXGBoostSHAPFine-tuning LoRA / QLoRA

Mise en production

DockerCI/CDFastAPIGitTests automatisés

Données

SQL avancé (CTE, fenêtrage) ↗PostgreSQLNeo4jETLPower BI
Formation

Se former, puis le prouver

Un cours de SQL de 30 heures, une formation Python et machine learning, des certifications vérifiables sur Credly, et des projets qui mettent tout cela en pratique.

SQL

Formation SQL de 30 heures

SQL Full Course for Beginners (30 Hours) par Data with Baraa

  • 30 heures
  • Gratuit
  • mars 2025

Un cours vidéo complet, suivi de bout en bout : des premières requêtes jusqu'à l'optimisation et à un entrepôt de données. La mise en pratique est dans un projet : 878 000 lignes de vente analysées avec des requêtes SQL analytiques.

Ce que j'y ai appris

  1. Les bases du langageSELECT, filtrage des données, et les commandes DDL et DML pour créer et modifier tables et données.
  2. Jointures et opérateurs ensemblistesJointures de base et avancées, puis les opérateurs ensemblistes pour combiner des résultats.
  3. Fonctions et logiqueFonctions de texte, de nombres et de dates, gestion des NULL, CASE et fonctions d'agrégation.
  4. Fonctions de fenêtrageLe plus gros morceau du cours, près de quatre heures : agrégats, classements et valeurs sur fenêtre.
  5. SQL avancéSous-requêtes, CTE, vues, tables temporaires, procédures stockées et triggers.
  6. PerformanceIndex, plans d'exécution, partitions et une trentaine de conseils d'optimisation.
  7. Trois projets pour finirUn entrepôt de données (couches Bronze, Silver, Gold), une analyse exploratoire et une analyse de données avancée.
YouTube
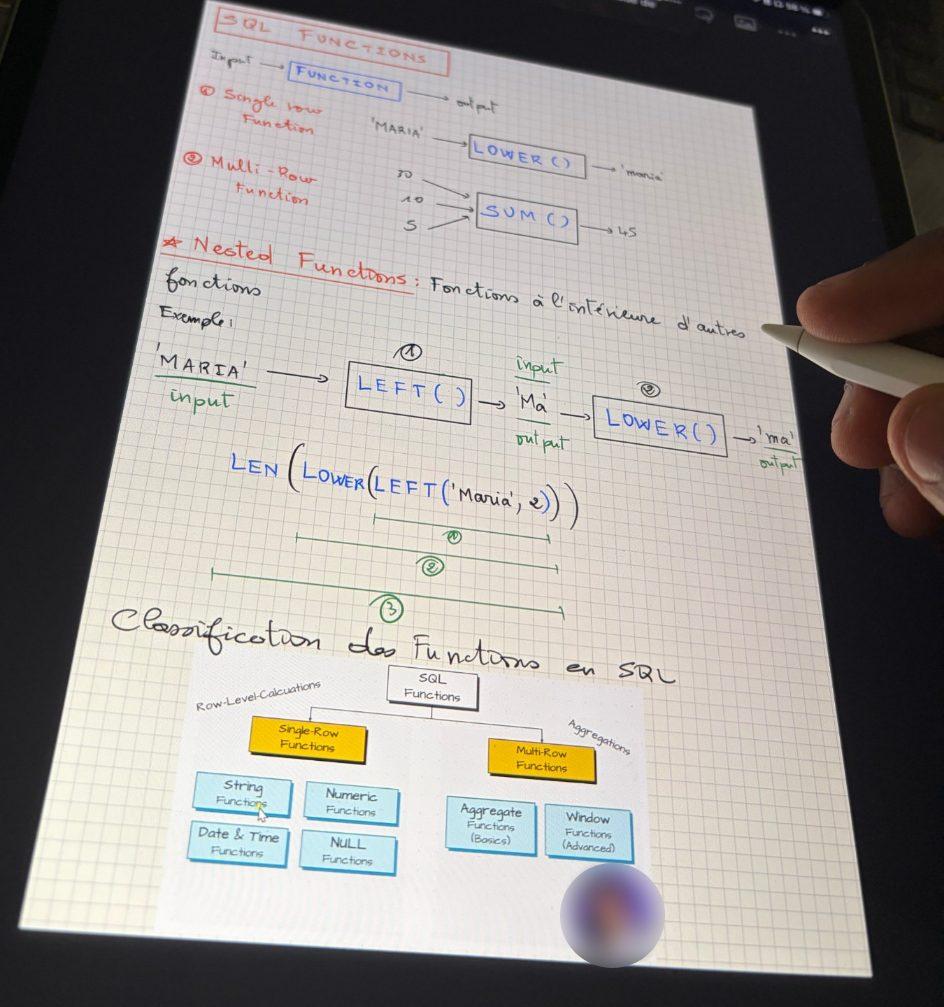
Mes notes manuscrites sur les fonctions SQL, prises sur une tablette pendant le cours
Mes notes de cours, à la main : les fonctions SQL.

Python · Machine Learning

Formation Python et machine learning

Formation Python Machine Learning par Machine Learnia (Guillaume Saint-Cirgue)

  • 30 vidéos
  • Gratuit
  • septembre 2019

Suivie à côté des certifications Coursera pour apprendre la data science : une série de trente vidéos qui prend en main les bibliothèques de référence de Python pour la donnée et le machine learning.

Bibliothèques abordées

  • NumPy
  • Pandas
  • Matplotlib
  • SciPy
  • Scikit-learn
  • Seaborn
  • H5py

Certifications vérifiables

Databases and SQL for Data Science

Coursera · mai 2025

SQL et bases de données relationnelles, appliqués à la data science.

Vérifier sur Credly

IBM Data Analyst Professional Certificate

Coursera · mai 2025

Analyse de données de bout en bout : Excel, SQL, Python et visualisation.

Vérifier sur Credly

Google Advanced Data Analytics Certificate

Coursera · mars 2025

Analyse de données avancée : statistiques, Python et initiation au machine learning.

Vérifier sur Credly

Python for Data Science and AI

Coursera · mai 2025

Python pour la donnée : les bases du langage et les bibliothèques d'analyse.

Vérifier sur Credly
Méthode

Comment je travaille

Cadrer

Définir ce qu'on mesure avant de construire : la métrique, le jeu de test, ce qui compterait comme un échec.

Préparer la donnée

La difficulté est souvent la donnée : la constituer, la nettoyer, la valider. Pour Mina, 500 paires générées, 360 retenues après un audit automatique.

Construire

Un projet en modules, reproductible, pas un notebook : agent, entraînement, évaluation et démonstration séparés.

Prouver

Évaluer avec la bonne méthode : magasin contrôle, test statistique, suite RAGAS. Un résultat non mesuré n'existe pas.

Déployer

Conteneuriser, servir derrière une API, intégration continue. Puis observer ce qui tourne réellement.

En ce moment j'apprends...

LLMOps & Déploiement de modèles

CI/CD ML, monitoring, drift et inference en production

Architecture

Clean Architecture et Domain-Driven Design

DevOps

CI/CD avec GitHub Actions, Docker en production

Travaillons ensemble

Vous avez un projet en tête ou une opportunité à me proposer ? Je suis toujours ouvert à la discussion.

Me contacter